我做了一个浏览器扩展:把网页生词一键收进「不背单词」
起因:一个很小的烦恼
我平时看技术文档、英文博客、Wikipedia,经常会卡在一些不认识的单词上。频率不高,但足够烦人——每次遇到,都得中断阅读,切到词典查一下,再想想「这词要不要记下来」。
真要记的话,路径更长:打开背单词 App,手动搜索,手动加进生词本。一个词点五六下,读一篇文档遇到十个生词,光录入就十几分钟过去了。
也试过现成的单词本,但它们和「我当下正在读的这篇网页」是脱节的。词书按主题或考试划分,而我读的是 Github Readme、某个库的 RFC、英文论文——这些页面里的词汇分布,任何一本预制词书都覆盖不好。
我真正想要的其实很简单:看到一篇英文文章,把它里面的生词一次性收集出来,直接进我正在用的背单词 App 的生词本。 这样背的词就是我这周真实读到的词,针对性拉满。
背单词 App 我用的是「不背单词」(bbdc.cn),所以就围绕它做。工具的名字叫「单词雷达 WordRadar」——雷达扫一遍页面,生词就现形了。
功能介绍:极致简约
一键添加网页单词到「不背单词」
最近高频接触各种各样的开源项目和 SKILLs,每天都要直面开源项目文档和 SKILL 介绍等各种英文单词。屡屡查词不如一次背词,索性直接全部添加到生词本,背完便能无障碍阅读原文。
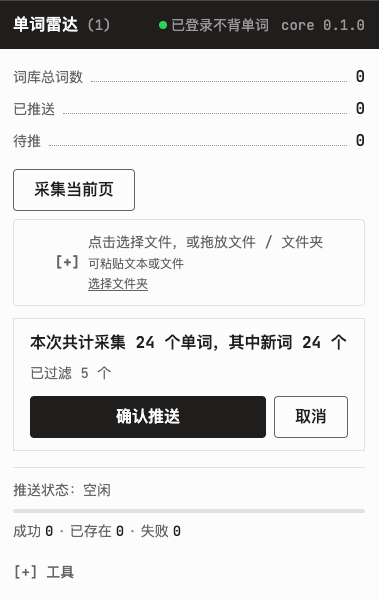
点一下扩展图标、再点一下「采集当前页」,扩展就把正文里的英文单词全部提取出来,和本地词库对比,弹窗告诉你:本次采集了 N 个单词,其中 M 个是新词。如果不想添加整页单词到生词本,也可以只处理选中文本。词形还原与去重
采集不是把页面上所有英文词都抓下来完事:先做归一化(所有格剥离,dog's算dog;大小写折叠,全大写的THE归到the),再做词形还原(cameras归到camera,went归到go),按词元去重,过滤缩略词和缩合形式。所以lived、living、lives不会以三个词条的面目重复出现在你面前。本地上传
硬盘里的英文笔记、字幕文件,直接在扩展里上传.txt/.md采集,走同一个推送流程。安装便捷
Chrome / Edge 商店直接装,随版本发布自动更新,不用自己下载源码编译。装好之后打开 bbdc.cn 登录一次,就能开始用。