使用生财 MCP 构建 LLM-WIKI
什么是 LLM-WIKI
LLM-WIKI 是 Andrej Karpathy 大神 2026 年 4 月提出来的一个理念,核心是让大语言模型把阅读、理解、综合、交叉引用、矛盾发现和问答,持续沉淀为一个持久、结构化、互链、带引用的 Markdown 知识库。
Agent owns the wiki; human owns the judgment.
它可以:
- 把离散的信息沉淀成结构化的知识库:通过理解、提炼、总结,把生财有术海量优质内容转换成清洗、糅合过的知识库。从文档中提取 概念/实体/总结 等多层结构,帮助我们更好地理解信息。
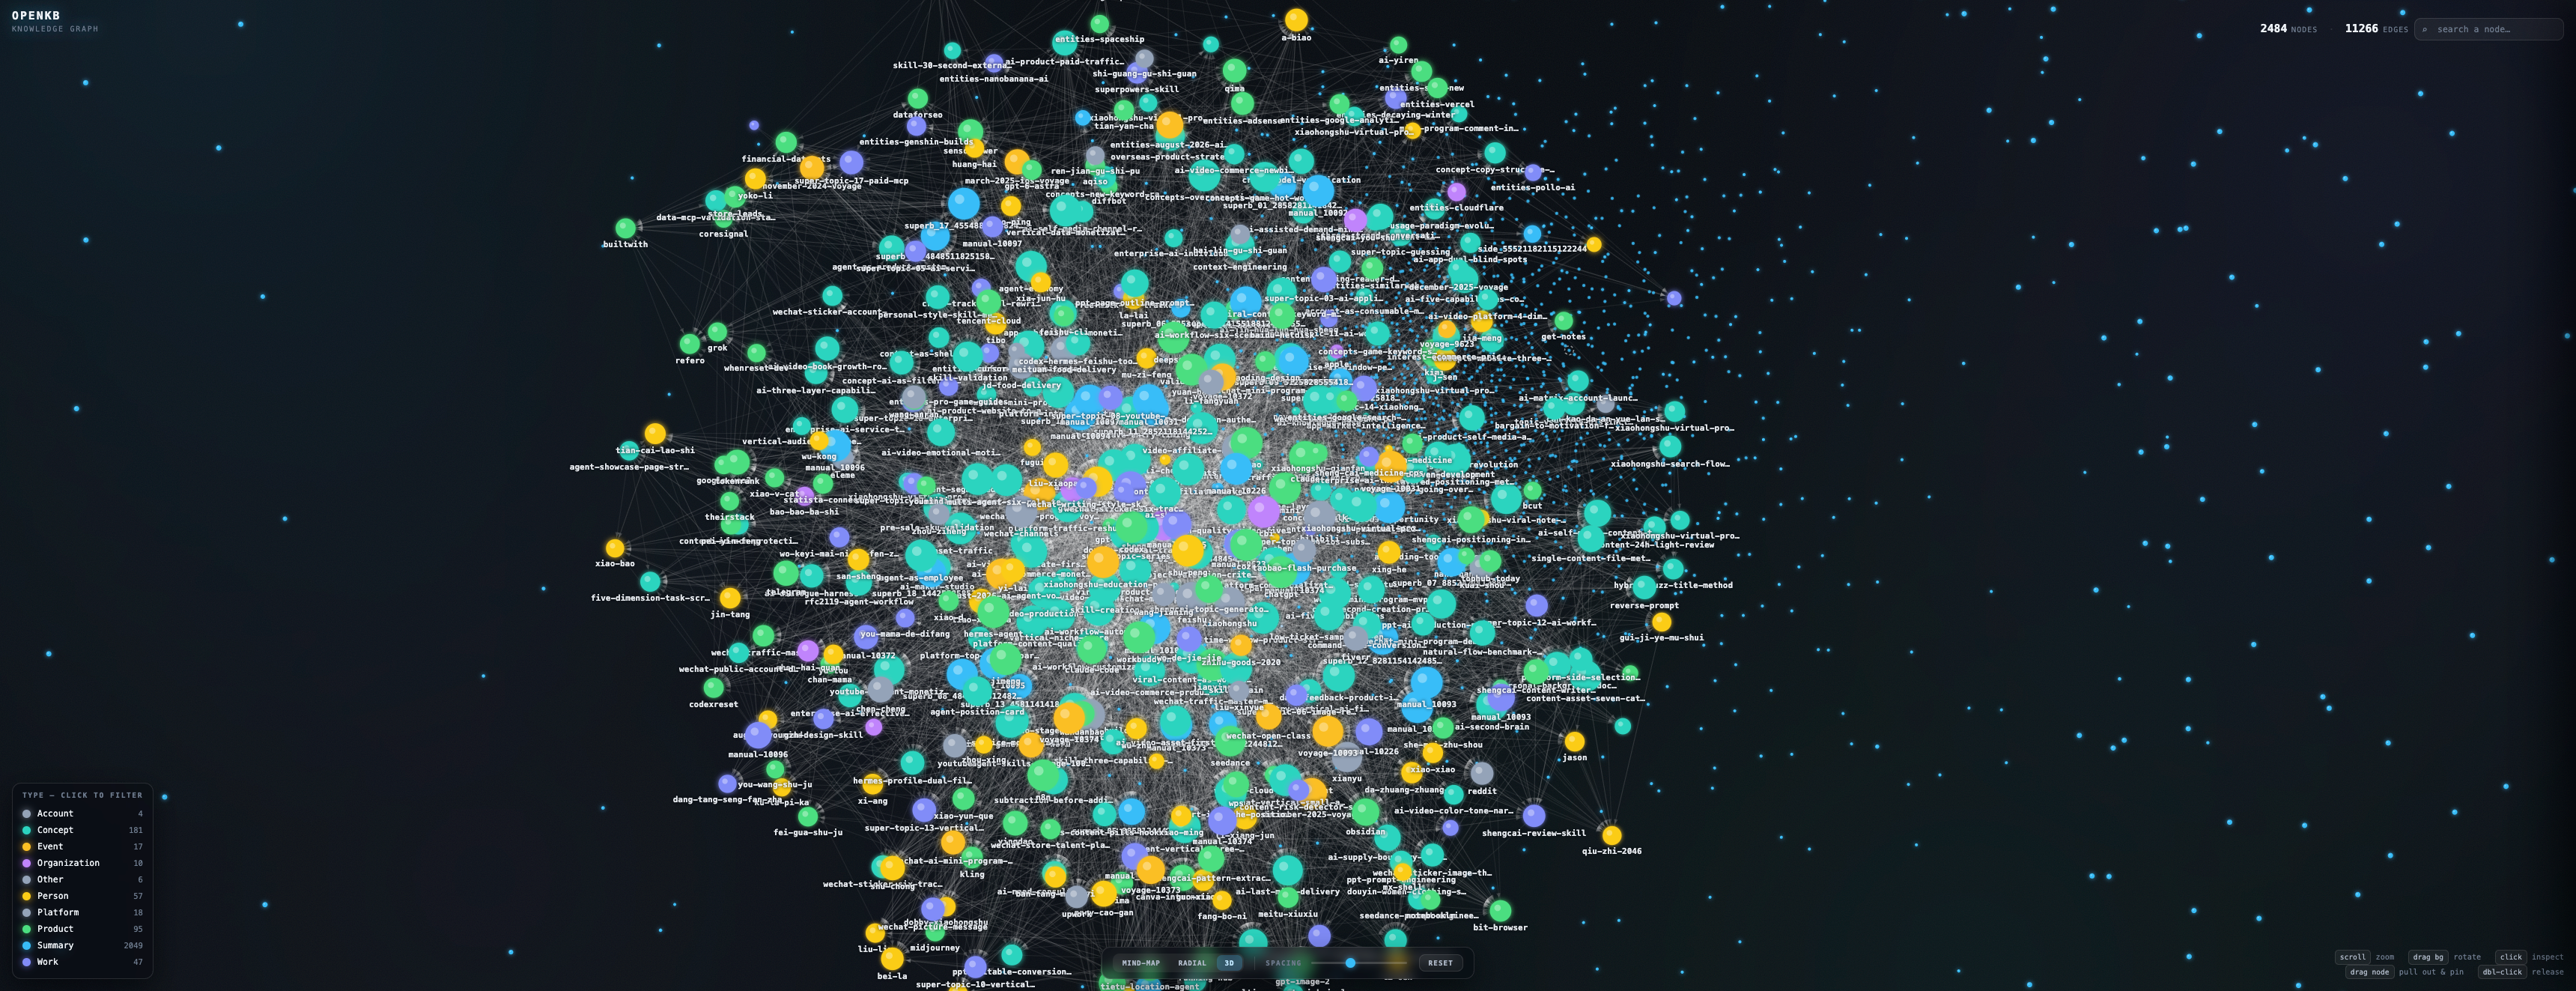
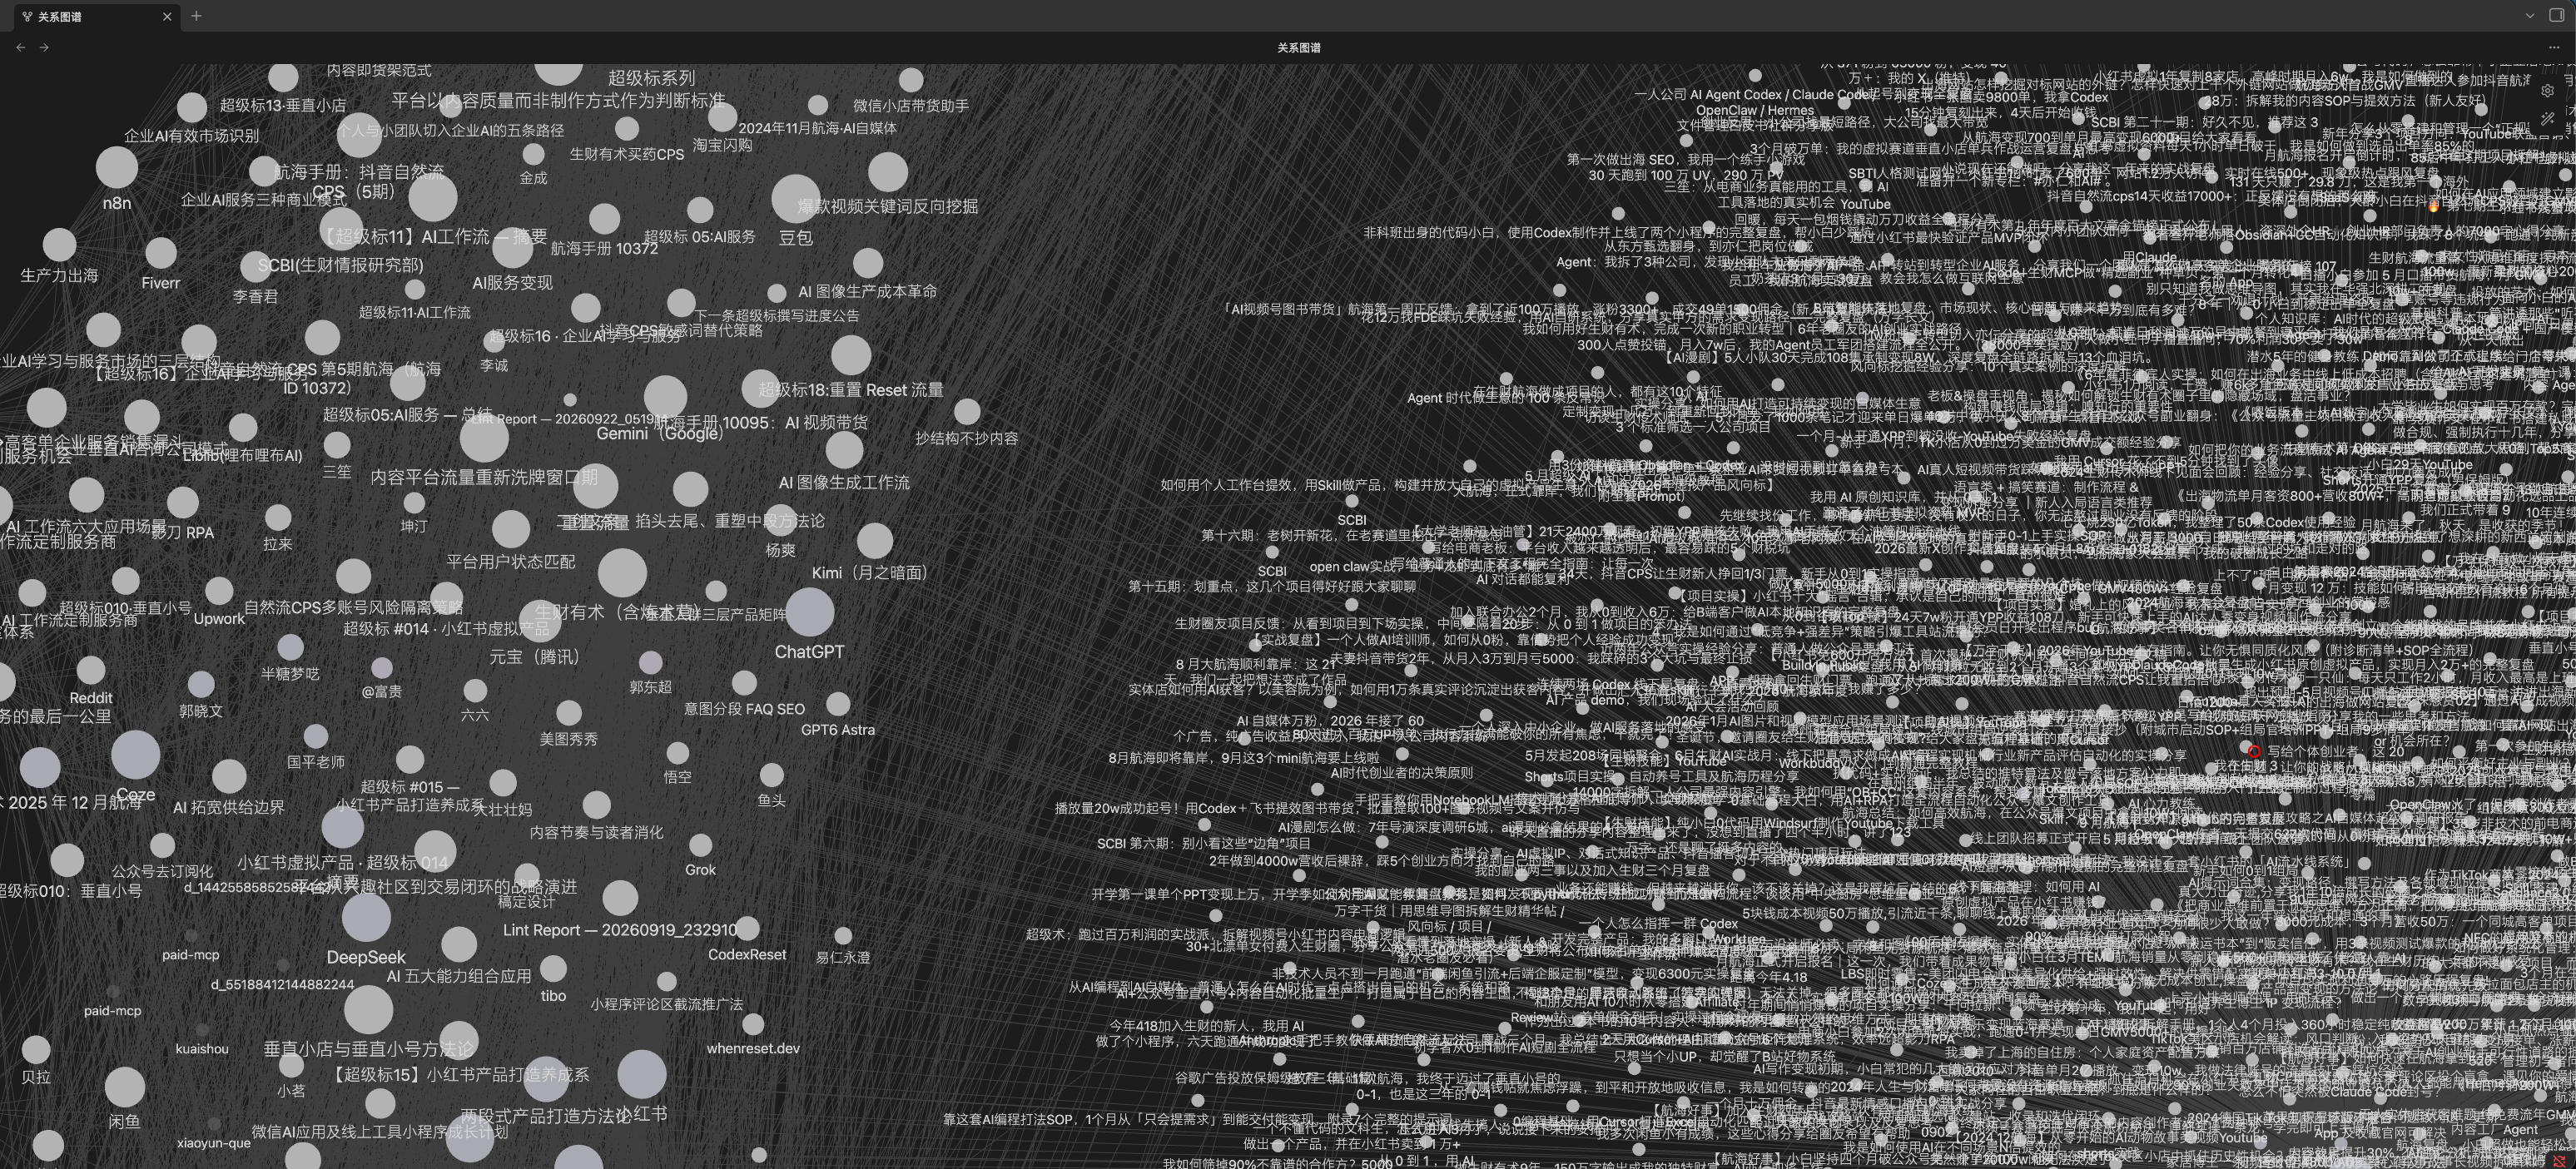
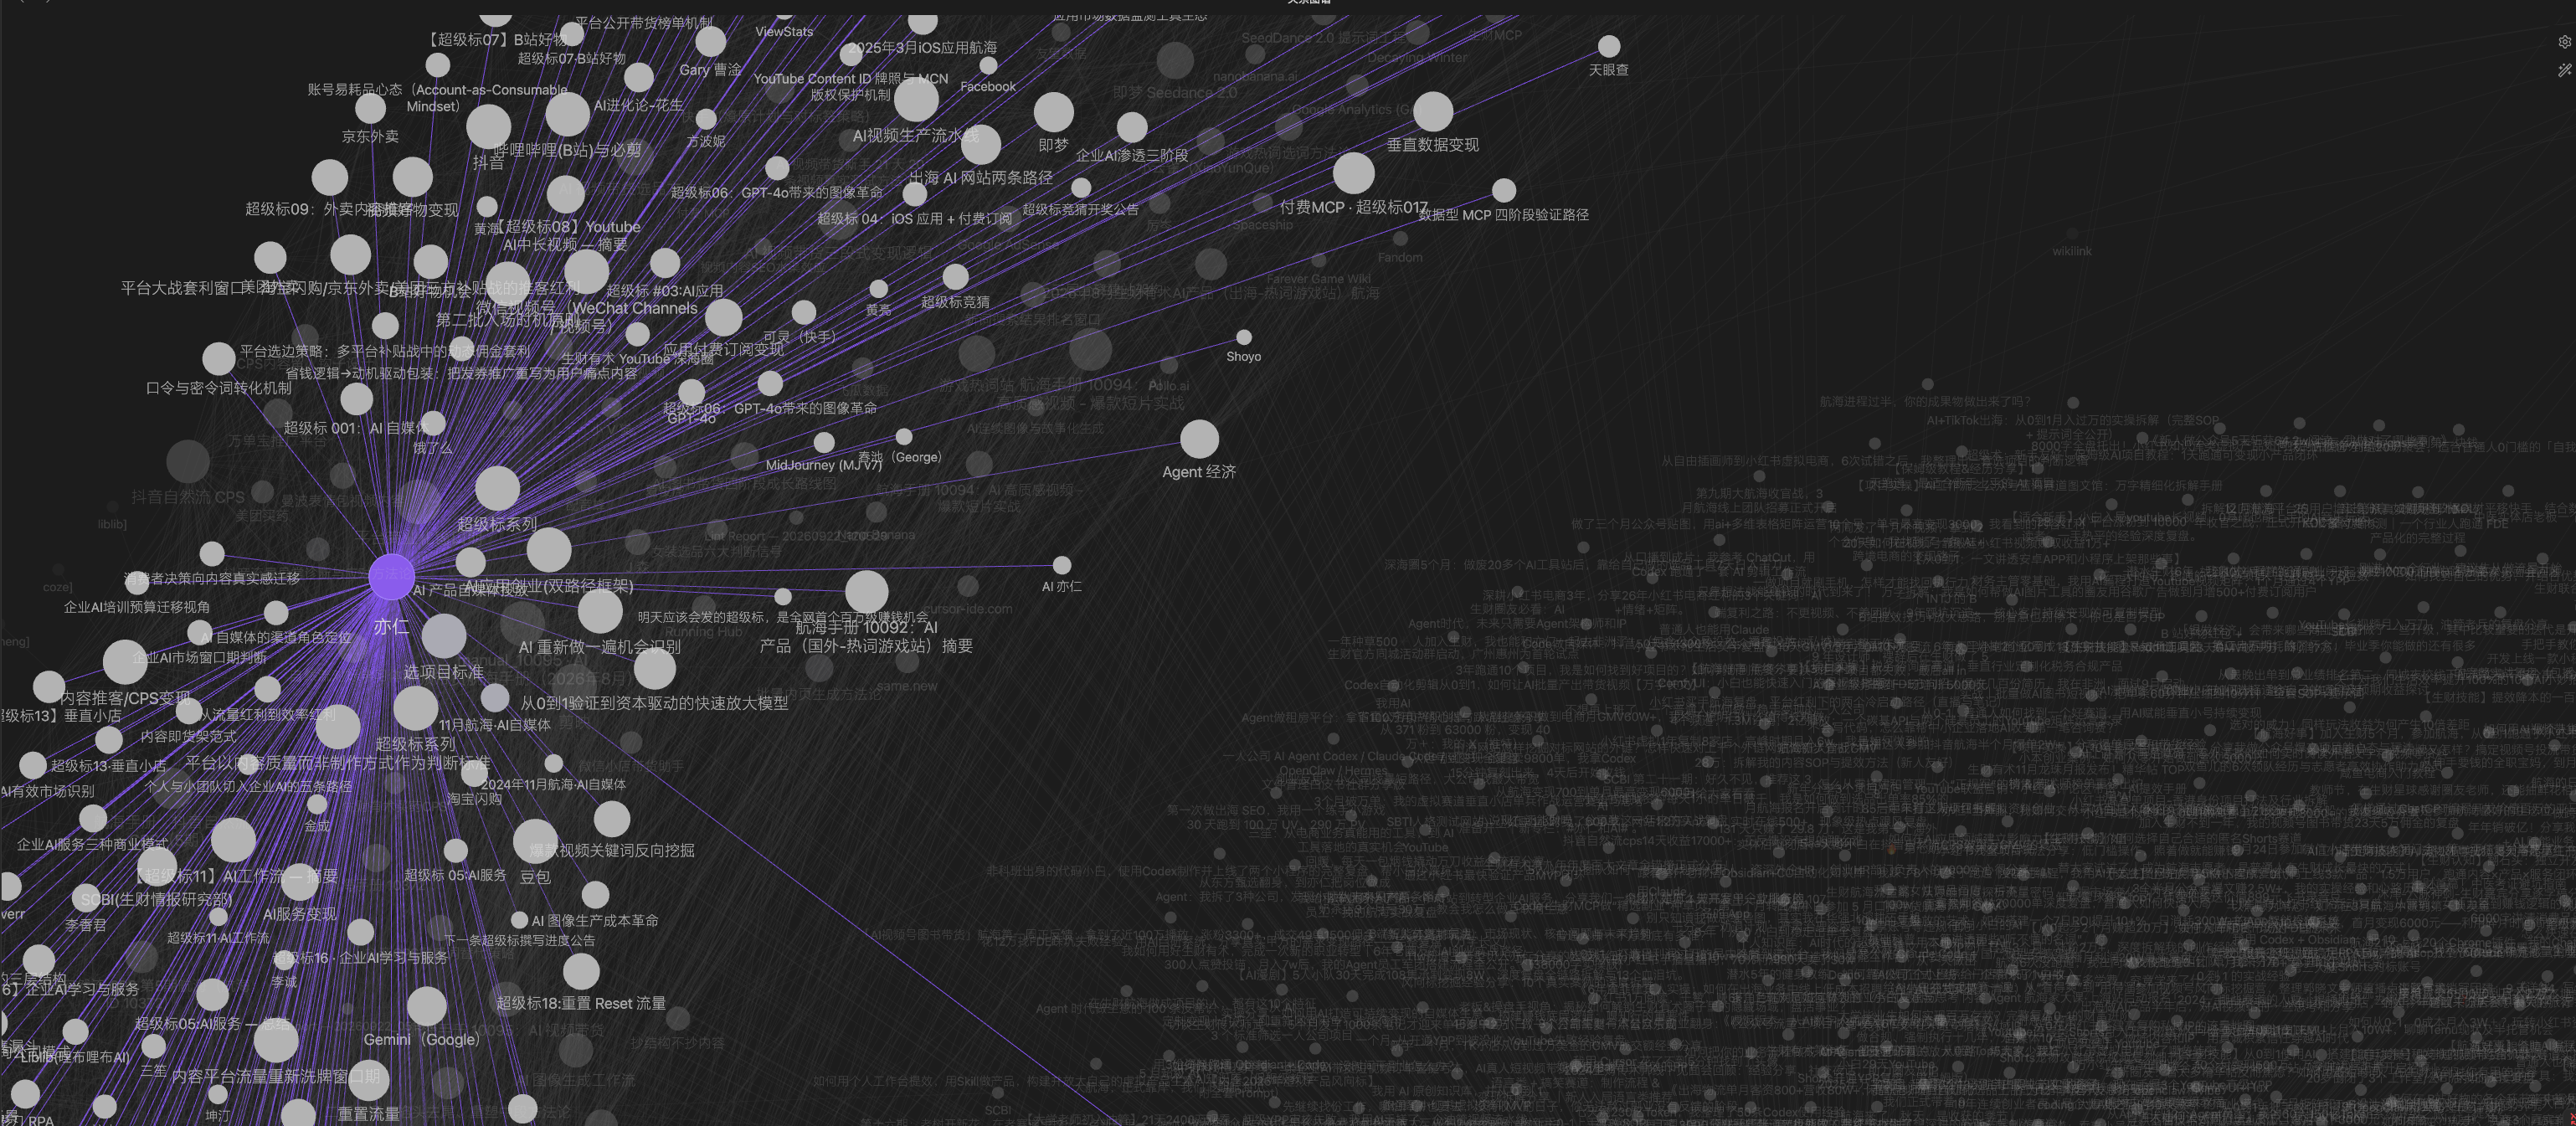
- 把文档集合转化为概念图谱:通过 wikilink 在文档和文档之间建立关联,关系脉络一目了然。
- 把问答的过程转换成知识维护过程:有价值的问答沉淀进知识库,问答本身也可以是知识。
- 把 LLM 的阅读工作从一次性消耗变成复利资产:LLM-WIKI 的每次摄入都会沉淀知识,告别传统一次性消耗。
- 维护知识:知识库不是死物,通过定期的 lint 检查和维护知识库,检查断链、修正引用关系、处理冲突、更新陈旧事实,防止知识库腐化。
一张图看懂 LLM-WIKI:
1 | flowchart TD |
通过 “资料进入 → 知识编译 → 问答复用 → 好答案回写 → 定期维护 → 知识继续变好” 的核心循环打造知识复利。
OpenKB 是 LLM-WIKI 理念的开源实现。借助 OpenKB,我们可以方便快捷地搭建知识库,而不是从零搞基建。
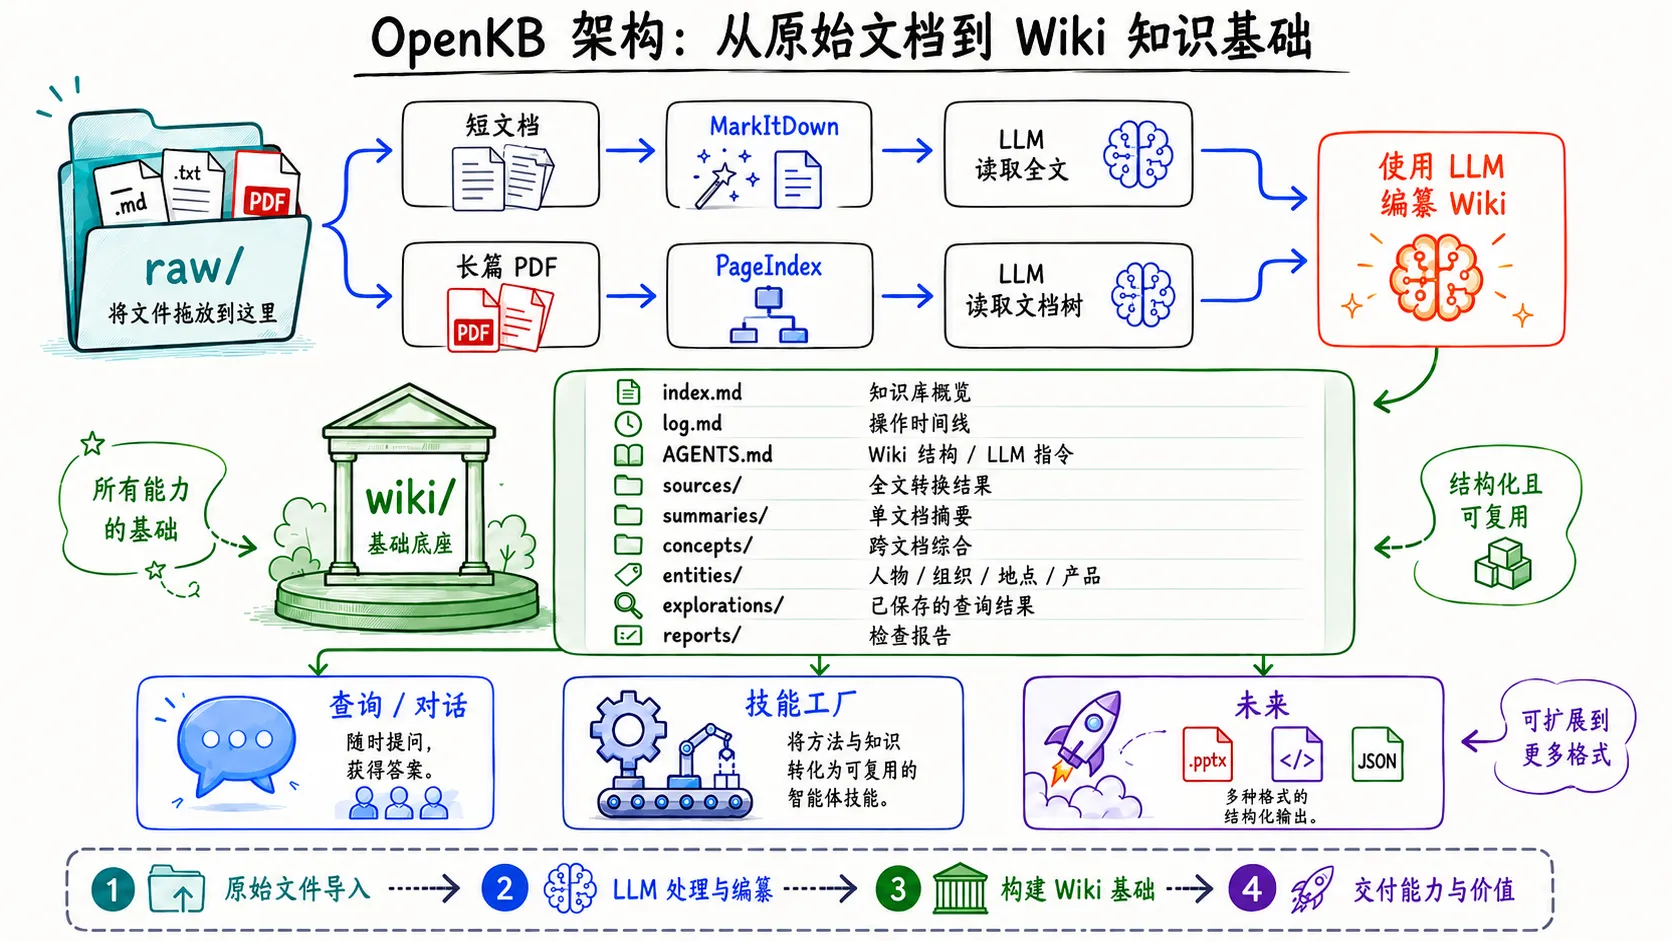
生财有术 LLM-WIKI 可以实现什么效果?
构建知识图谱
- OpenKB 知识图谱:
![OpenKB 知识图谱]()
- Obsidian 关系图谱:
![Obsidian 关系图谱]()
- Obsidian 关系图谱-亦仁:
![Obsidian 关系图谱-亦仁]()
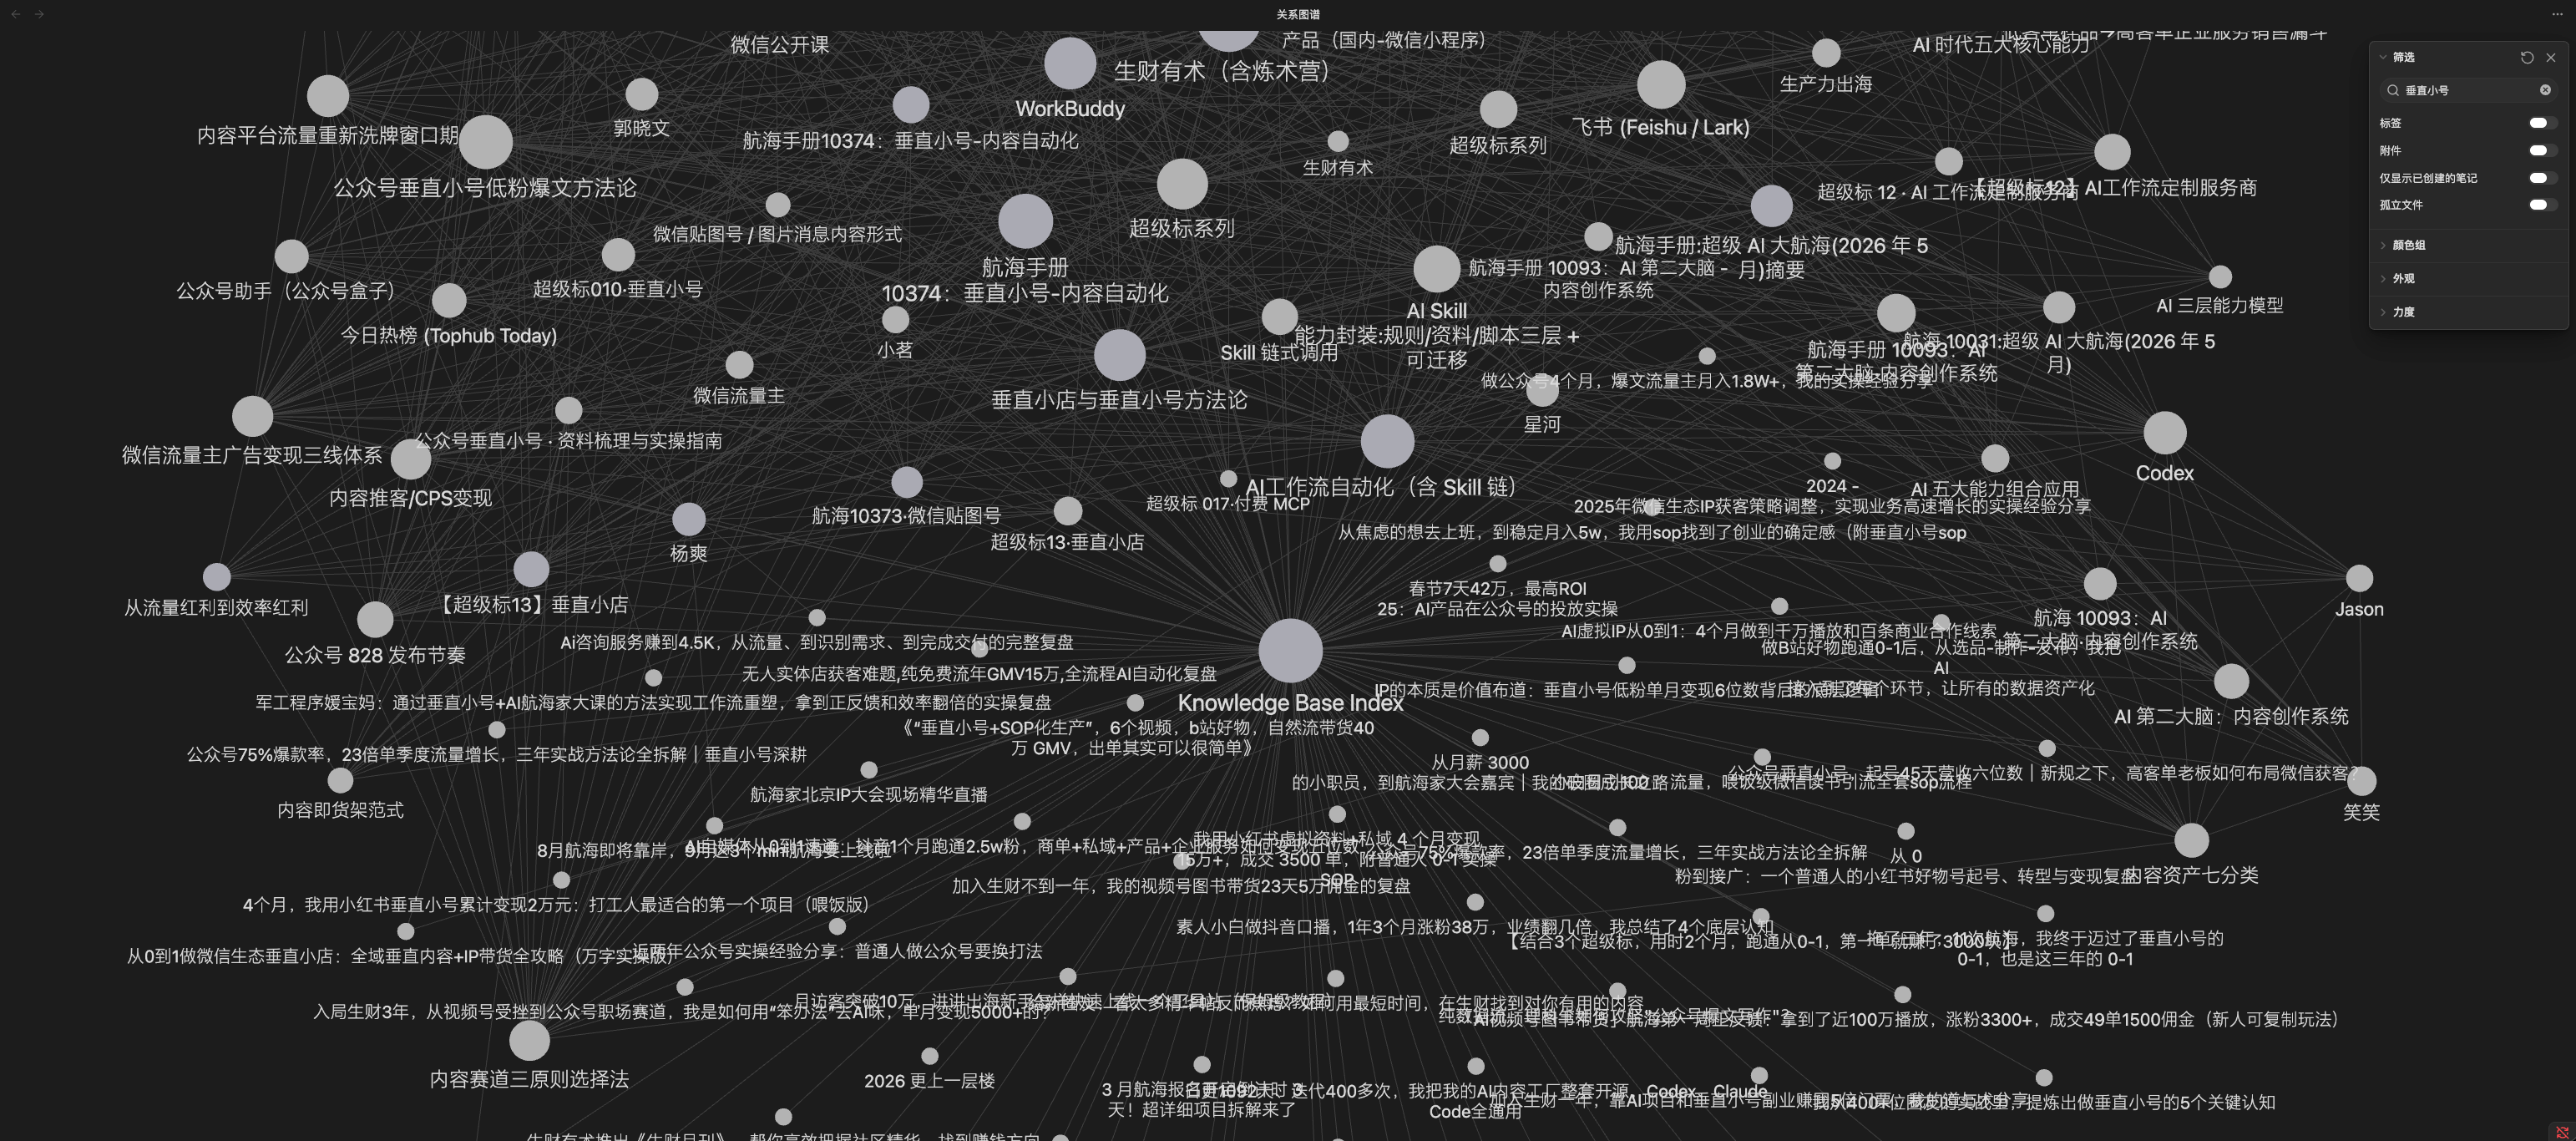
- Obsidian 关系图谱-垂直小号:
![Obsidian 关系图谱-垂直小号]()
问答
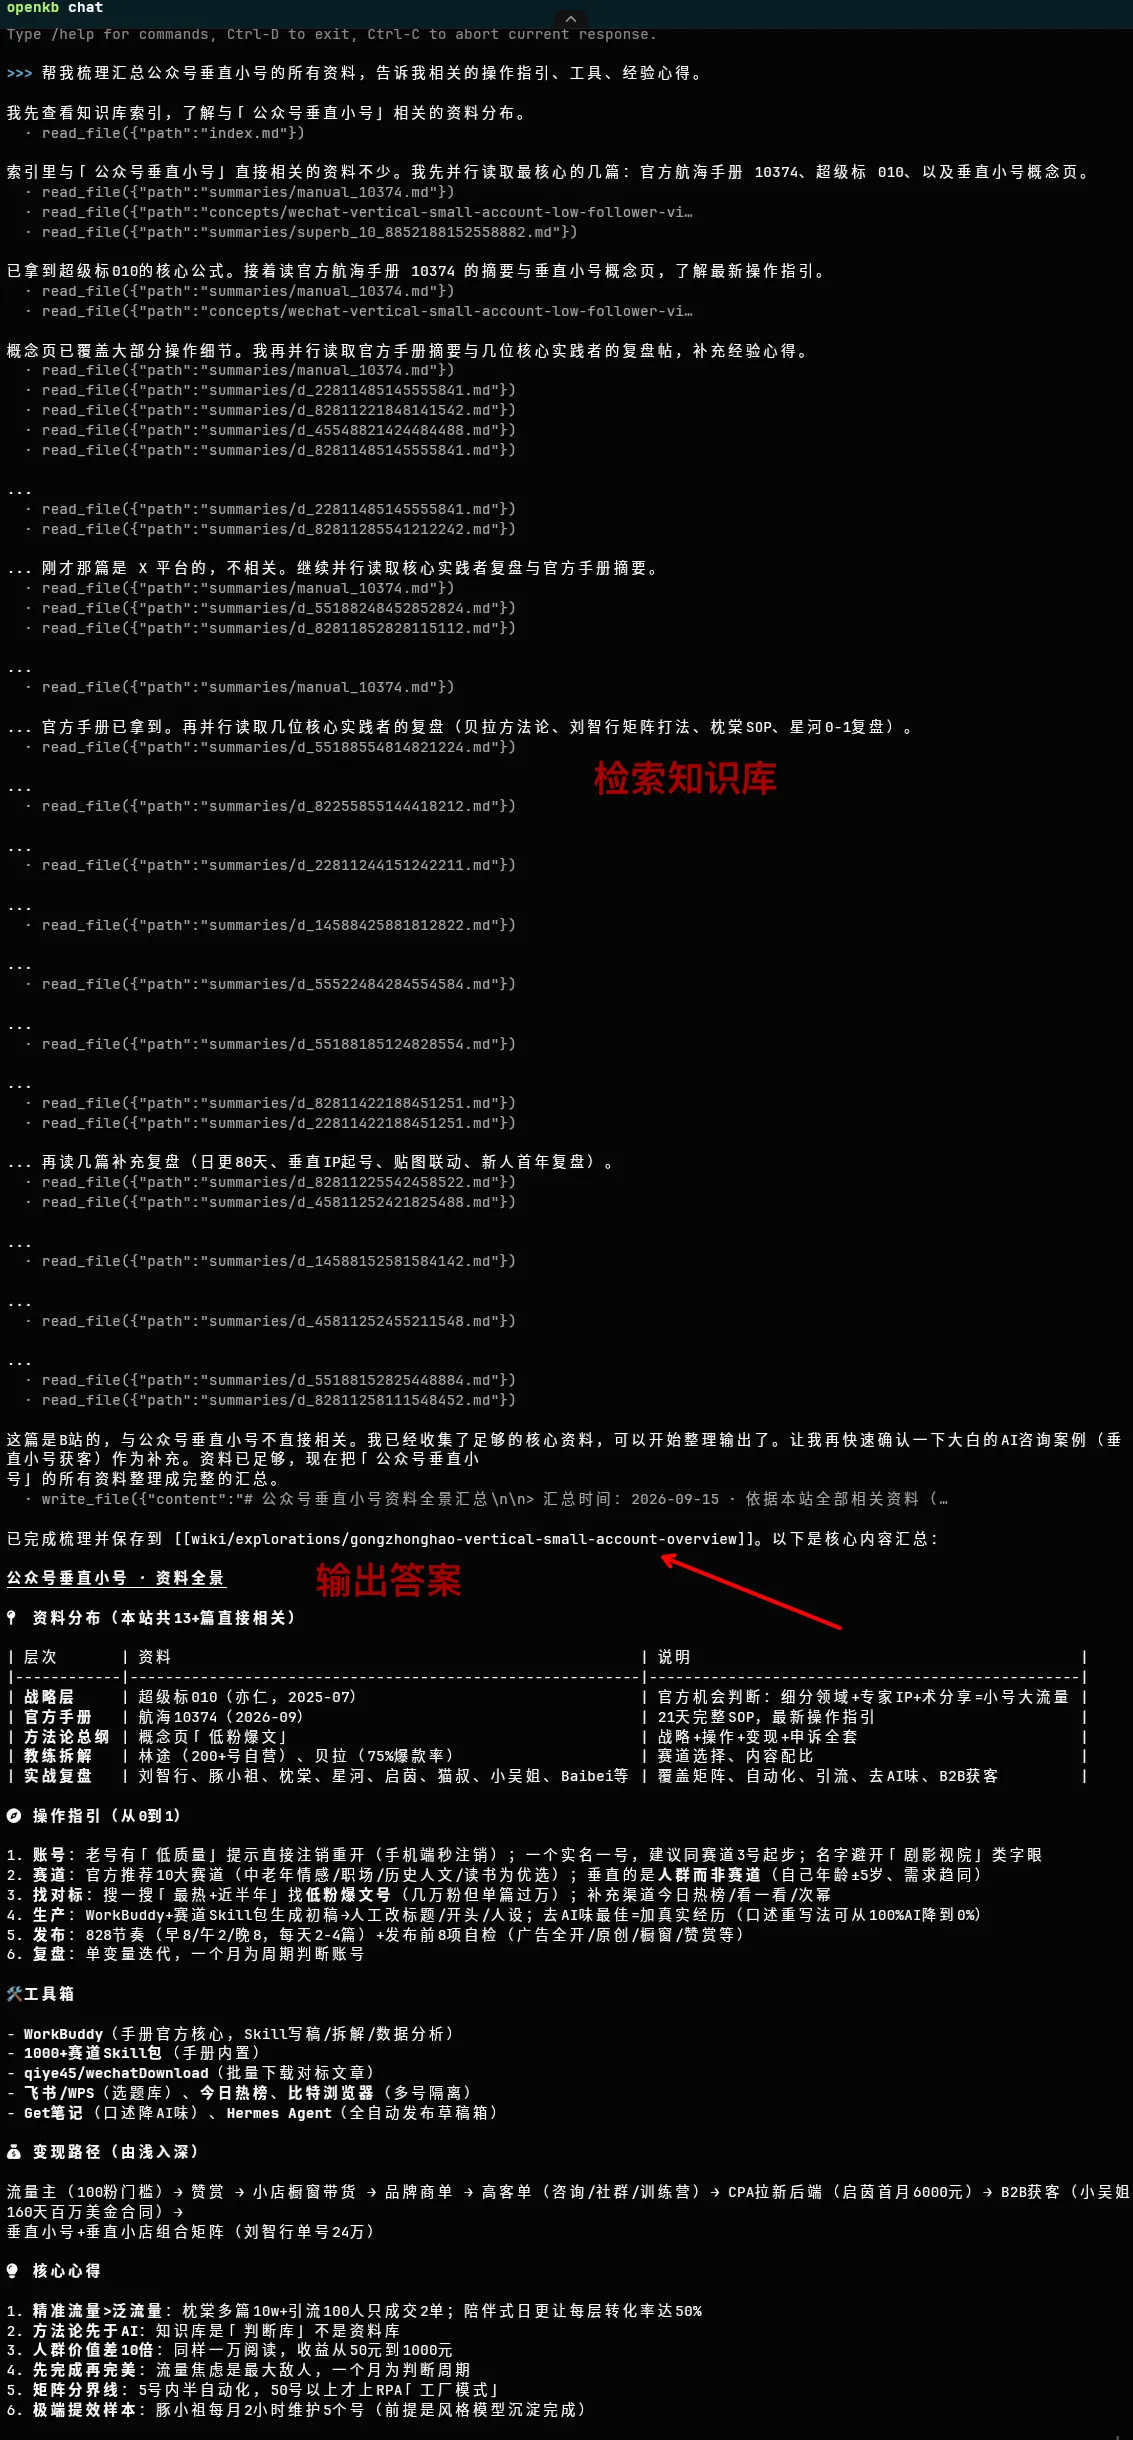
- 问:“帮我梳理汇总公众号垂直小号的所有资料,告诉我相关的操作指引、工具、经验心得。”
![openkb-chat-vertical-small-account]()
怎么用生财有术 MCP 构建 LLM-WIKI?
我们需要用到:
- scys-mcp:获取数据
- openkb:加工数据
- LLM API:openkb 大脑
- AI Agent Client:执行助理
1 | flowchart LR |
构建过程极其简单,只需要创建一个 wiki 文件夹、使用你喜欢的 AI Agent 打开这个文件夹,全程只需要跟 AI Agent 对话:
有了 AI,很多操作都可以变得非常简单。
参考 生财有术 MCP 上手指南 安装测试 scys-mcp。
初始化 OpenKB:
1
使用 https://github.com/VectifyAI/OpenKB 初始化当前 wiki, LLM API 的配置信息可以让我协助配置。
初始化项目上下文:
1
2
初始化项目,写入 AGENTS.md 上下文。
当前项目的目的是使用 scys-mcp 读取生财有术最近半年所有精华帖、超级标、航海手册,并且写入 openkb wiki。执行数据采集与 WIKI 构建:
1
使用 scys-mcp 读取生财有术最近半年所有精华帖、超级标、航海手册,并且写入 openkb wiki。
就是这么简单。
一些可能让你体验更舒服的优化项:
把数据采集过程持久化为 SKILL:
1
结合项目上下文,分析最近几次 scys-mcp 数据采集过程和 openkb 知识入库过程,帮我把数据采集和知识沉淀过程生成 scys-ingest skill。
优化/修正知识库内容:
1
2
根据已经爬取的信息,优化 openkb metadata, openkb wiki 文件命名规则等,并持久化规则指引后续数据更新。
(这里按照自己的需求定制就好)日常的 wiki lint 检查和维护:
1
使用 openkb lint 检查知识库并修正发现的问题。
从 WIKI 中提炼可复用的 Skills:
1
2
3
使用 openkb skill new 指令帮我提炼 skill:
- skill-name: <skill 名称>
- intent: <意图:你想要提炼什么样的 skill>有能力的话,数据采集和入库过程可以做成定时任务。我们只管维护就好了。
后记
- AI 赋予我们远超以往的能力,常使我们自觉“无所不能”。我们应该是 AI 的主人,而非奴隶。腾云驾雾的间隙,别忘了巩固自身。多看一些官方文档,知其然、知其所以然,知应如何进、知从何处退。
- 尽最快的速度,用上你知道的能最快上手的 AI;尽最大的努力,用上你能用上的最厉害的 AI。
- 只懂皮毛技术,业务常感生疏。行文略显生硬,各位看官见谅。技术只是躯壳,业务注入灵魂。是强是弱,还得辛苦各位定制和调教。
- 生财有术是少有的开放、互利共赢社群,祝大家早日大发!数据采集尽可能晚上跑吧,不要给生财服务器增加太多压力
- 数据采集不要贪心,大而全未必更好。小而精更显专注。