我做了一个浏览器扩展:把网页生词一键收进「不背单词」
起因:一个很小的烦恼
我平时看技术文档、英文博客、Wikipedia,经常会卡在一些不认识的单词上。频率不高,但足够烦人——每次遇到,都得中断阅读,切到词典查一下,再想想「这词要不要记下来」。
真要记的话,路径更长:打开背单词 App,手动搜索,手动加进生词本。一个词点五六下,读一篇文档遇到十个生词,光录入就十几分钟过去了。
也试过现成的单词本,但它们和「我当下正在读的这篇网页」是脱节的。词书按主题或考试划分,而我读的是 Github Readme、某个库的 RFC、英文论文——这些页面里的词汇分布,任何一本预制词书都覆盖不好。
我真正想要的其实很简单:看到一篇英文文章,把它里面的生词一次性收集出来,直接进我正在用的背单词 App 的生词本。 这样背的词就是我这周真实读到的词,针对性拉满。
背单词 App 我用的是「不背单词」(bbdc.cn),所以就围绕它做。工具的名字叫「单词雷达 WordRadar」——雷达扫一遍页面,生词就现形了。
功能介绍:极致简约
一键添加网页单词到「不背单词」
最近高频接触各种各样的开源项目和 SKILLs,每天都要直面开源项目文档和 SKILL 介绍等各种英文单词。屡屡查词不如一次背词,索性直接全部添加到生词本,背完便能无障碍阅读原文。
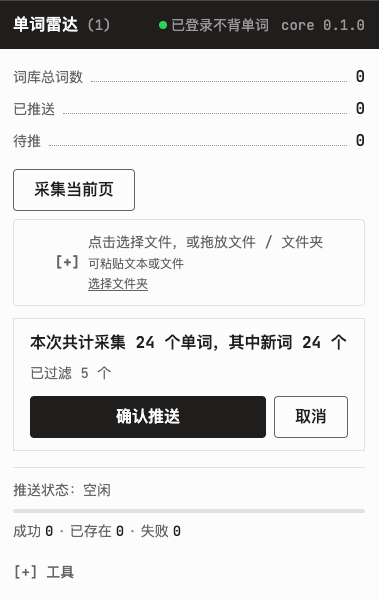
点一下扩展图标、再点一下「采集当前页」,扩展就把正文里的英文单词全部提取出来,和本地词库对比,弹窗告诉你:本次采集了 N 个单词,其中 M 个是新词。如果不想添加整页单词到生词本,也可以只处理选中文本。词形还原与去重
采集不是把页面上所有英文词都抓下来完事:先做归一化(所有格剥离,dog's算dog;大小写折叠,全大写的THE归到the),再做词形还原(cameras归到camera,went归到go),按词元去重,过滤缩略词和缩合形式。所以lived、living、lives不会以三个词条的面目重复出现在你面前。本地上传
硬盘里的英文笔记、字幕文件,直接在扩展里上传.txt/.md采集,走同一个推送流程。安装便捷
Chrome / Edge 商店直接装,随版本发布自动更新,不用自己下载源码编译。装好之后打开 bbdc.cn 登录一次,就能开始用。
开发历程:从「能不能打通」到「敢不敢上架」
第一步:先解决「最后一公里」
这个项目最大的不确定性不在前端,而在最后一环——能不能把一个词程序化地写进不背单词的生词本。如果这条路走不通,前面采集做得再漂亮也没有意义。
「不背单词」没有公开的加词 API。我逆向了它的官方查词插件,摸清了网页端逐词加生词本的接口,再用真实账号实测打通,整个项目从「想法」变成「可行」。
第二步:跑通最小闭环
第一个版本(0.1.0)目标很克制:网页采集 → 本地词库(IndexedDB)→ 确认后推送。架构上做了扩展 + CLI 双形态,共享同一份 TypeScript 核心包。
这个阶段解决的都是「让它真的能用」的问题:
- MV3 的 service worker 会在纯网络请求循环中被浏览器杀掉,导致长词表推到一半静默停滞。解法是在推送循环里定期穿插扩展 API 调用作心跳保活。
- 采集和入库之间有竞态,弹窗的计数偶尔恒为 0,需要把消息链路改成完整的应答式。
- 词形还原引入了 compromise 这个 NLP 库,配上不规则动词表和保守的后缀回退。
第三步:把它变成「别人也能装」的产品
1.0.0 是第一个上架 Chrome Web Store 的版本,主题是从「自己能用」到「敢给别人用」:
- 加了确认闸门:采集结果先集中展示,确认后才入库推送——把「人在回路」从习惯固化成机制。
- 推送进度实时可见:从轮询改成事件驱动,工具栏图标上还有 badge 回执,推送到第几个词、成没成功,一眼可见。
- 加了错误日志的环形缓冲和一键导出:真出了问题,用户能把日志发给我。
- 支持上传文件采集,补上了三语界面(简体、繁体、英文),弹窗视觉整体重做成了一套统一的 man-page 风格设计。
商店上架本身也是一次学习:Chrome Web Store 后台的表单结构、审核流程、隐私声明口径,都整理成了文档沉淀在仓库里。后来又上架了 Edge 商店。
第四步:和「词」的边角料长期作战
最有意思也最耗时间的,是那些听起来不像问题的问题。1.1.0 这一大版本几乎都在打磨「什么算一个该收录的词」:
- 缩略词要不要收? 像
docs、app、stat这类词,在技术页面里满天飞,但背它们没什么意义。我做了一条构建管线,从 Wiktionary 的缩略词类目生成黑名单,再用词频表做守卫防止误杀。即便如此还是翻过车:fox这种常用词曾因为词条数据污染被静默过滤掉,the fox's den里的 fox 都不放过。修这类问题的过程让我把「缩略词的判定标准」从直觉提炼成了明确规则:看词源,不看常用度。 - 词形还原会制造不存在的词。
pyjamas被还原成pyjamave,active被改写成actife——这类畸形词元一旦入库,去重和黑名单匹配全部失效。解法是给还原管线加词典守门:还原结果得是真实存在的词,否则回退原词形。 - 并发与时序的暗坑:推送进行中用户又确认了一批新词怎么办?弹窗关了又开、驻留的待确认批次怎么处理?这些用户永远不该感知到的问题,靠一轮一轮的 e2e 测试和重构去堵。
到这个阶段,仓库里已经有了单元测试、Playwright 端到端测试、构建期数据自检,词形还原的行为漂移会在两三个小时的构建管线一开始就被哨兵断言拦下来,而不是跑完才悄悄产出不一致的结果。
设计原则:几条刻意保持的克制
回看整个过程,有几条原则一直在约束这个工具,我觉得也是它能保持简单的原因:
- 人在回路:确认即推送是唯一入库路径,永不后台自动推送。工具可以帮你省事,但不能替你做决定。
- 拾取做轻,背诵外包:不解释词义,不安排复习,「背」这件事全部交给成熟的不背单词。重复造轮子没有价值。
- 极简数据:本地词库一行一个词、一个位掩码,能不存的字段就不存——没有时间戳,没有来源,也没有释义。
- 最小权限:只申请
storage/activeTab/scripting三个权限,网络访问只限 bbdc.cn 和 langeasy.com.cn,不读 cookie,不采集页面内容以外的任何数据。 - 先跑通自用闭环再扩张:多端同步、更多背单词 App 渠道、宣传官网,都在后置清单上。第一个用户(我自己)的日常体验是一切判断的锚。
写在最后
单词雷达不是一个宏大的项目。它只是把「读英文网页 → 收集生词 → 针对性记忆」这条原本断成三截、每截都靠手动衔接的路径,焊成了一条点了两次鼠标就能走完的流水线。
如果你也读英文技术文档、也用不背单词,欢迎试试:Chrome 商店 | Edge 商店
如果你也有一些小痛点,试一试 AI 开发,打开新世界的大门!